WnioskowanieStatystyczne/Twierdzenie Bayesa
Wnioskowanie_Statystyczne_-_wykład
Spis treści
Prawdopodobieństwo warunkowe i zdarzenia niezależne
Zapis \(P(A\mid B)\) oznacza prawdopodobieństwo zdarzenia \(A\) liczone w sytuacji, gdy mamy pewność wystąpienia zdarzenia \(B\). Odpowiada to w pewnym sensie wystąpieniu obydwu zdarzeń (\(A\cap B\)), jednak prawdopodobieństwo tej sytuacji należy obliczać inaczej niż \(P(A\cap B\)).
Przykład: Niech \(A\) oznacza wyrzucenie szóstki, a \(B\) — wyrzucenie parzystej liczby oczek w rzucie kostką. Wtedy \(A\cap B\) oznacza wyrzucenie szóstki, \(P(A\cap B)=\frac{1}{6}\). Jednak jeśli bierzemy pod uwagę tylko te przypadki, w których wyrzucono parzystą liczbę oczek (2, 4 lub 6), to \(P(A\mid B)=\frac{1}{3}\).
Rozważmy \(P(A\mid\Omega)\); dla dowolnego \(A\)
mamy
- \( P(A)=P(A\mid\Omega)=P(A\cap\Omega)\)
bo oczywiście \(A\in\Omega\).
Rozbijając przestrzeń wszystkich możliwych zdarzeń \(\Omega\) na część odpowiadającą zdarzeniu \(B\) i pozostałą \(\overline B\) (\(\Omega=B\cup\overline{B}\)), dostajemy:
- \( P(A)=P(A\mid\Omega)=\\ P\left(A\cap(B\cup\overline{B})\right)=\\ P\left((A\cap B)\cup(A\cap\overline{B})\right)=\\ P(A\cap B) + P(A\cap\overline{B})\)
czyli prawdopodobieństwo zdarzenia \(A\) jest równe sumie
prawdopodobieństw zajścia \(A\), jeśli zaszło również
\(B\), oraz prawdopodobieństwa zajścia \(A\), jeśli
\(B\) nie zaszło. Jeśli wiemy, że zaszło zdarzenie
\(B\) (wszak liczymy \(P(\cdot\mid B)\)), to drugi
człon znika (\(P(\overline{B})=0\)). Aby uzyskać wzór na
\(P(A\mid B)\), pozostały człon musimy podzielić przez
\(P(B)\) (aby dla \(B=A\) było \(P(A\mid
A)=1\))
- \( P(A\mid B)=\frac{P(A\cap B)}{P(B)} \)
Jeśli wystąpienie zdarzenia \(B\) nie ma żadnego wpływu na
prawdopodobieństwo wystąpienia zdarzenia \(A\), czyli
\(P(A\mid B)=P(A)\), to mówimy, że zdarzenia \(A\) i
\(B\) są niezależne. Z powyższego równania wynika, że dla zdarzeń niezależnych \(A\) i \(B\) zachodzić będzie
\(
P(A\cap B)=P(A)P(B)
\)
W przykładzie z kostką:
- \(P(\textrm{parzysta liczba oczek})=\frac{1}{2}\),
- \(P(\mathrm{szóstka})=\frac{1}{6}\),
- \(P(\mathrm{szóstka} | \textrm{parzysta liczba oczek}) = \dfrac{\frac16}{\frac12} = \frac13\).
Twierdzenie Bayesa
Twierdzenie Bayesa można wyprowadzić z elementarnych reguł prawdopodobieństwa, wychodząc z powyższej definicji prawdopodobieństwa warunkowego. Ponieważ interesuje nas głównie weryfikacja hipotez statystycznych, przekształćmy ten wzór, wstawiając od razu zamiast zdarzeń \(A\) i \(B\) hipotezę \(H\) i dane \(D\). Wtedy \(P(D\mid H)\) będzie prawdopodobieństwem wylosowania danych \(D\) pod warunkiem, że prawdziwa jest hipoteza \(H\):
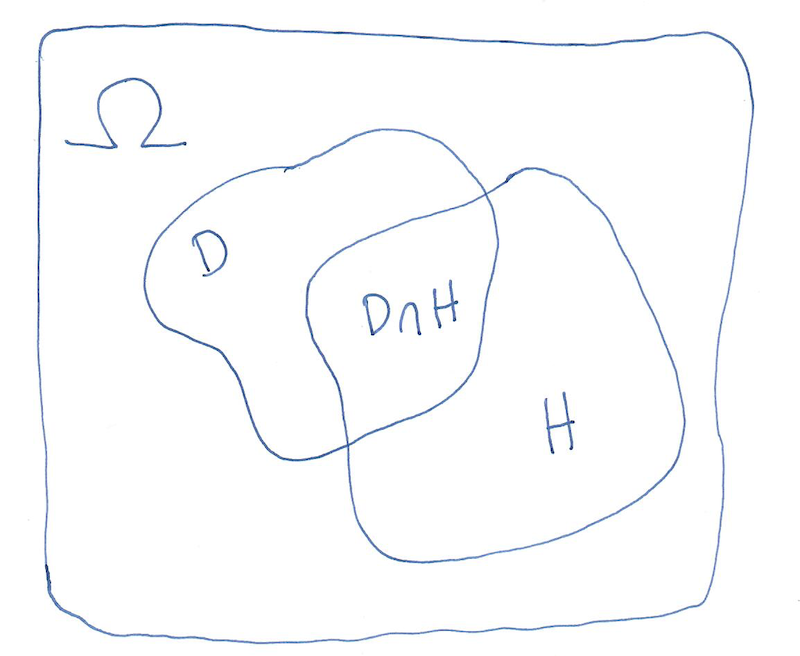
Analogicznie
\( P(H\mid D) = \frac{P(H\cap D)}{P(D)} \Longrightarrow P(H\cap D)=P(H\mid D) P(D). \)
Ponieważ
\(P(D\cap H)=P(H\cap D)\)
czyli
\(P(D\mid H) P(H) = P(H\mid D) P(D)\)
dostajemy
Prawdopodobieństwo \(P(D)\) uzyskania w doświadczeniu danych
\(D\) trudno ocenić bezpośrednio, jeśli nie wiemy, czy
prawdziwa jest odnosząca się do nich hipoteza \(H\). W tej
sytuacji należy wziąć pod uwagę wszystkie możliwe hipotezy
\(H_i\), tworzące kompletny, czyli pokrywający całą
przestrzeń \(\Omega\): \(\sum_i H_i=\Omega\) zbiór
hipotez \(H_i\) wykluczających się wzajemnie \(\left(
P(H_i\cap H_j)=0 \right)\). Wtedy
\(
P(D)=P(D\cap\Omega)=\sum_i P(D\cap H_i).
\)
Korzystając z (1) dostajemy
\(
P(D)=\sum_i P(D\mid H_i) P(H_i) \,\,\,\,\,\, (3)
\)
Wstawiając tę zależność do (2), i podstawiając za
\(H\) jedną z możliwych \(H_i\), dostajemy wzór
wyrażający twierdzenie Bayesa:
\(
P(H_i\mid D)=\frac{P(D\mid H_i)P(H_i)}{\sum_j P(D\mid H_j)P(H_j)}.
\)
Prawdopodobieństwo hipotezy \(H_i\) wyrażone jest przez:
- prawdopodobieństwo uzyskania w jej świetle danych \(D\), czyli \(P(D\mid H_i)\)
- stopień naszego zaufania do hipotezy \(H_i\) (niezależny od eksperymentu, w którym uzyskaliśmy dane \(D\)), czyli \(P(H_i)\)
- całkowite prawdopodobieństwo uzyskania danych \(D\) w świetle wszystkich możliwych hipotez \(H_j\), czyli \(\sum_j P(D\mid H_j)P(H_j)\)
Najbardziej bulwersujące jest tu \(P(H_i)\), wyrażające naszą wiarę w hipotezę \(H_i\) niezależną od danych \(D\). Wielkość tę określa się mianem prawdopodobieństwa "a priori", lub jak proponuje R. Nowak, "prawdopodobieństwem zaczątkowym" lub "zaczątkiem" . Dla odróżnienia od (szukanego) prawdopodobieństwa \(P(H)\) oznaczmy zaczątek jako \(P_0\); wzór Bayesa przyjmie wtedy postać
Jeśli nie dysponujemy informacją o kompletnym zbiorze hipotez \(H_i\), możemy badać stosunek prawdopodobieństw dwóch hipotez \(H_1\) i \(H_2\):
Przykłady
Celem wnioskowania statystycznego powinna być ocena prawdopodobieństwa prawdziwości hipotezy \(H\) w świetle zdarzenia opisanego obserwowanymi danymi \(D\), a nie odwrotnie. Mylenie tych dwóch prawdopodobieństw prowadzi np. do tzw. błędu rozumowania prokuratorskiego.
Poniższe przykłady zaczerpnięto z raportu Giuglio D'Agostini "Bayesian Reasoning in High Energy Physics - Principles and Applications".
Prawdopodobieństwo zarażenia w świetle wyników testu na HIV
Przypadkowo wybrany z populacji (w której na 60 milionów jest około stu tysięcy nosicieli wirusa) obywatel poddany jest testowi na obecność wirusa HIV. Użyty test wykrywa niemal 100% przypadków zakażenia, i daje około 0,2% „fałszywych alarmów”. Jakie jest prawdopodobieństwo, że badany obywatel jest nosicielem wirusa, jeśli test dał wynik pozytywny?
Na pierwszy rzut oka wydaje się, że skoro test wykrywa wirusa fałszywie tylko w dwu przypadkach na tysiąc, to szukane prawdopodobieństwo wynosi 1-0,2%\(\approx\) 99.8%. Jednakże, jeśli wziąć pod uwagę prawdopodobieństwo a priori (zaczątek) wynoszące 100 000/60 000 000 \(\approx\) 0,17% otrzymamy wartość bliską 50%!
Na początek wyobraźmy sobie wynik tego testu na całej populacji: będzie on pozytywny dla stu tysięcy zarażonych i dla 0,2% pozostałych, czyli w sumie 220 tysięcy. Wśród nich faktycznych nosicieli będzie tylko sto tysięcy, pozostali będą ofiarami błędu testu. Prawdopodobieństwo, że jesteśmy nosicielem, jeśli znaleźliśmy się w tej grupie, jest równe \(\frac{100 000}{220000}\approx\) 45% (a nie 99,8%!).
Formalnie możemy dowieść tego wyniku korzystając z (2) i (4). Oznaczmy:
- \(P(+)\) — prawdopodobieństwo pozytywnego wyniku testu,
- \(P(HIV)\) — prawdopodobieństwo, że badany jest nosicielem (zaczątek),
- \(P(\overline{HIV})\) — prawdopodobieństwo, że badany nie jest nosicielem (również zaczątek).
Z opisu przykładu dostaniemy:
\(P(+|HIV)\approx 1\),
\(P(+|\overline{HIV})=0,002\),
\(P(HIV)= \frac{100 000}{60 000 000} = \frac{1}{600}\)
\(P(\overline{HIV}) \approx 1\).
Szukamy \(P(HIV|+)\):
\(\begin{matrix} P(HIV|+)& =& \frac{P(+|HIV)P(HIV)}{P(+)}\\ P(\overline{HIV}|+)& = &\frac{P(+|\overline{HIV})P(\overline{HIV})}{P(+)}\\ \frac{P(HIV|+)}{P(\overline{HIV}|+)}&=&\frac{P(+|HIV)P(HIV)}{P(+|\overline{HIV})P(\overline{HIV})} = \frac{1 \cdot \frac{1}{600}}{0,002 \cdot 1} = \frac{1}{1,2}. \end{matrix}\)
Ponieważ \(P(HIV|+) + P(\overline{HIV}|+) = 1\), dostajemy \(P(HIV|+) \approx 0.455\), czyli ok. 45%
Uaktualnianie prawdopodobnieńswa zaczątkowego czyli Bayes w barze
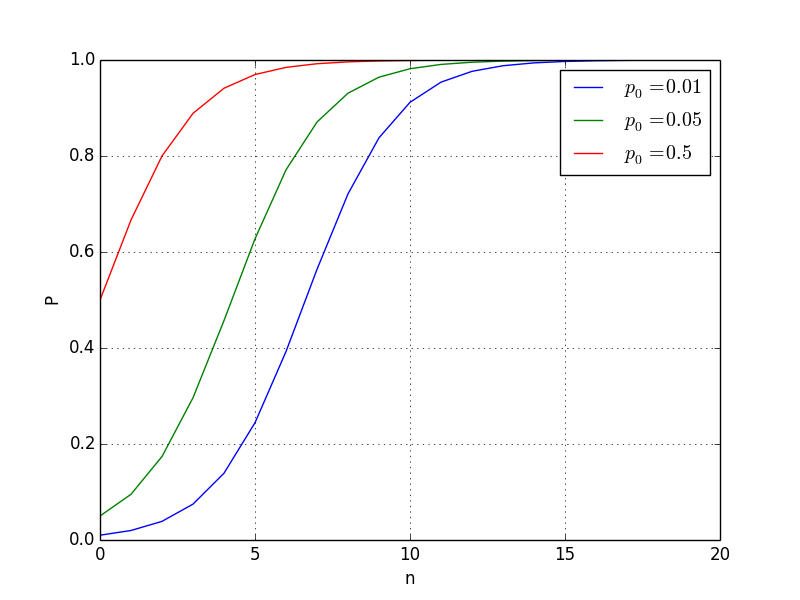
Spotykamy w barze znajomego, który proponuje prostą grę losową: za drinki płaci ten, kto wyciągnie z zakrytej talii niższą kartę. Zgadzamy się wierząc w losowość gry (czyli uczciwość znajomego, który grę prowadzi), ale jeśli przegramy kilka razy z rzędu zaczynamy wątpić. Opiszmy to liczbami:
Na początku przyjmujemy, że znajomy proponuje uczciwą grę losową, z prawdopodobieństwem na przykład \(P_0(U)=0.95\). Poziom naszej początkowej wiary z możliwość przeciwną, czyli że jeteśmy oszukiwani, wynosi wtedy \(P_0(O)=0.05\). Dla uproszczenia załóżmy, że jeśli prowadzący grę znajomy oszukuje, to zawsze wygra, czyli prawdopodobieństwo wygrania w każdej z gier wyniesie wtedy \(P(W|O)=1\). Jeśli gra byłaby uczciwa (losowa), to prawdopodobieństwo wygrania w każdej grze wynosiłoby \(0.5\), czyli \(P(W|U)=2^{-1}\). Jeśli kolejne gry są zdarzeniami niezależnymi, to prawdopodobieństwo wygrania w \(n\) kolejnych grach wyniesie \(P(W_n|U)=2^{-n}\).
Ostatecznie
\( P(O|W_n)=\frac{ P(W_n|O) P_0(O) }{ P(W_n|O) P_0(O) + P(W_n|U) P_0(U) } \)
\(
P(O|W_n)=\frac{P_0(O) }{ P_0(O) +2^{-n} [1 - P_0(O)] }
\)
| kod |
import matplotlib.pyplot as plt
import numpy
t = numpy.arange(0, 20.0, 1.0)
def p(n,p0c):
	return p0c/(p0c+(1-p0c)*0.5**n)
plt.plot(t, p(t, 0.01), label='$p_0=0.01$')
plt.plot(t, p(t, 0.05), label='$p_0=0.05$')
plt.plot(t, p(t, 0.5), label='$p_0=0.5$')
plt.xlabel('n')
plt.ylabel('P')
plt.grid(True)
plt.legend()
plt.show()
|
|
Referencja
Polecam doskonały tekst Giuglio D'Agostini z 1995 roku pt. "Probability and Measurement Uncertainty in Physics — a Bayesian Primer", dostępny z https://arxiv.org/abs/hep-ph/9512295