WnioskowanieStatystyczne/Test serii
Wnioskowanie_Statystyczne_-_wykład
Spis treści
Test serii Walda-Wolfowitza
Serią nazywamy ciąg jednakowych elementów. W poniższym przykładzie mamy sześć serii (po trzy serie zer i jedynek):
\(\underline{1}\overline{00}\underline{1}\overline{00}\underline{111} \overline{0}\)
Nie jest to oczywiście jedyna kombinacja kolejności pięciu zer i pięciu jedynek, dająca w wyniku sześć serii. Ponieważ każda pojedyncza kombinacja jest jednakowo prawdopodobna (jeśli jest wynikiem niezależnych losowań), to prawdopodobieństwo uzyskania danej liczby serii będzie tym większe, im więcej różnych kombinacji będzie dawać w wyniku tę liczbę serii. Sformułujmy więc problem ogólnie:
Mamy \(N=n_1+n_2\) elementów, w tym \(n_1\) zer i \(n_2\) jedynek. Na ile sposobów możemy je rozłożyć, aby uzyskać \(k\) serii?
| kod |
import matplotlib.pyplot as plt
import numpy

n1=25 # zera
n2=30 # jedynki
n=n1+n2
ile_losowan=1000

wynik=numpy.zeros(ile_losowan, dtype=numpy.int32)

for i in range(0, ile_losowan):
	losowanie=numpy.zeros(n, dtype=numpy.int32)
	while numpy.sum(losowanie) < n2:
		losowanie[numpy.random.randint(0,n)]=1
	#print(numpy.array_str(losowanie,max_line_width=numpy.inf).replace(" ",""), "\n")
	zmiany=1
	for j in range(1, n):
		if(losowanie[j] != losowanie[j-1]):
			zmiany += 1
	wynik[i]=zmiany

plt.hist(wynik, bins=range(0,n))
plt.xlabel("$k$")
plt.ylabel("$P(k)$")
plt.title(f"$n_1$ = {n1}, $n_2$ = {n2}, {ile_losowan} losowań")
plt.show()
|
| animacja dla 1000 |
Wyprowadzenie analityczne
Wróćmy do prostszego przykładu, zawierającego pięć jedynek i pięć zer. Podział na serie możemy interpretować jak przypisanie liczbom od jeden do dziesięciu (pozycje w ciągu) zera lub jedynki:
| 1 | 0 | 0 | 1 | 0 | 0 | 1 | 1 | 1 | 0 |
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
Inaczej mówiąc, konkretny ciąg \(N\) zer i jedynek wyznaczony jest przez wylosowanie spośród liczb od jednego do \(N\) tych liczb, którym mają być przypisane jedynki (pozostałym będą przypisane zera — lub odwrotnie). Czyli wszystkich możliwych ciągów \(n_1\) zer i \(n_2\) jedynek będzie tyle, na ile sposobów można wylosować \(n_1\) elementów spośród \(N\). Policzmy: pozycję (czyli numer, wypisany w dolnym rzędzie powyższej tabeli) pierwszego elementu losujemy spośród \(N\) możliwości, drugiego — spośród \(N-1\) pozostałych możliwości (jedna pozycja jest już zajęta), i tak dalej, aż pozycję ostatniego z \(n_1\) elementów losujemy spośród \(N-n_1\) pozostałych możliwości. Liczba możliwych wyników będzie iloczynem tych wszystkich liczb, czyli wyniesie \(N\cdot(N-1)\cdot(N-2)\cdot\ \dots\ \cdot (N-n_1) = N!/(N-n_1)!\) Skoro wszystkie jedynki są jednakowe i nie rozróżniamy wyników różniących się ich kolejnością, to wynik ten musimy podzielić przez liczbę różnych ustawień kolejności elementów (liczbę permutacji) zbioru \(n_1\)-elementowego. Wyniesie ona \(n_1\cdot(n_1-1)\cdot\ \dots\ \cdot 1\), czyli \(n_1!\) Ostatecznie jako liczbę różnych ustawień \(n_1\) zer i \(N-n_1\) jedynek dostajemy:
\(\displaystyle \frac{N!}{(N-n_1)!\ n_1!} = \binom{N}{n_1} \)
Jest to znany z rozdziału o rozkładzie dwumianowym symbol Newtona \(\binom{N}{n_1}\). Jego własności symetrii zgadzają się z sytuacją, w ktorej "wybierać" możemy albo \(n_1\) zer albo \(n_2\) jedynek:
Pozostaje policzyć, ile z tych możliwości wygeneruje ciąg wyników, w którym będzie dokładnie \(k\) serii. W tym wyprowadzeniu odwracamy na chwilę role: \(n_1\) oznacza tu liczbę jedynek, a \(n_2\) liczbę zer. Wynik jest od tej umowy niezależny, bo wszystkie wzory poniżej są symetryczne względem zamiany \(n_1 \leftrightarrow n_2\); na końcu wracamy do oznaczeń z definicji.
\(\displaystyle\underline{1}\overline{00}\underline{1}\overline{00}\underline{111} \overline{0}\)
Jeśli liczba serii \(k\) jest parzysta
będziemy mieć tyle samo serii jedynek i zer (po \(k/2\)). Aby rozmieścić \(n_1\) jedynek w \(k/2\) seriach musimy wyznaczyć \(k/2-1\) punktów podziału na serie; w powyższym przykładzie będą to (kropki) 1.1.111 — było 6 serii, więc mamy 2 punkty podziału. Inaczej losujemy spośród \(n_1-1\) możliwych punktów podziału \(k/2-1\) podziałów, jak wynika z liczby serii \(k\). Daje to \(\binom{n_1-1}{k/2-1}\) możliwości. W miejsca podziału (oznaczone kropkami) wstawiamy serie zer; analogicznie możemy to zrobić na \(\binom{n_2-1}{k/2-1}\) możliwości (w przykładzie: 00.00.0). Liczbę tę należy pomnożyć przez dwa ze względu na możliwość zamiany miejscami zer i jedynek. Prawdopodobieństwo danej liczby serii dostaniemy — zgodnie z klasyczną definicją prawdopodobieństwa — dzieląc liczbę wszystkich tych kombinacji \(n_1\) jedynek i \(n_2\) zer, które generują dokładnie \(k\) serii, przez liczbę wszystkich możliwych kombinacji:
\(\displaystyle P=\frac{ 2\binom{n_1-1}{k/2-1} \binom{n_2-1}{k/2-1}} { \binom{N}{n_1}} \qquad\textrm{dla }\ k\ \textrm{parzystych.} \)
Jeśli liczba serii \(k\) jest nieparzysta
którychś serii — zer lub jedynek — będzie dokładnie o jeden więcej.
\(\displaystyle\underline{1}\overline{00}\underline{1}\overline{000}\underline{111} \)
Jeśli więcej jest serii jedynek, mamy \((k-1)/2\) serii zer i \((k-1)/2+1\) serii jedynek. \(n_1\) jedynek dzielimy na \((k-1)/2+1\) serii, czyli wyznaczamy \((k-1)/2\) punktów podziału spośród \(n_1-1\) możliwych — daje to \(\binom{n_1-1}{(k-1)/2}\) możliwości. Z kolei \(n_2\) zer dzielimy na \((k-1)/2\) serii, co daje \(\binom{n_2-1}{(k-1)/2-1}\) możliwości. Iloczyn tych dwóch wielkości określa liczbę możliwości dających \(k\) serii, jeśli więcej jest serii jedynek:
Jeśli więcej jest serii zer, to na drodze analogicznego rozumowania dostajemy
Prawdopodobieństwo dla przypadku nieparzystej liczby serii będzie sumą tych dwóch wielkości, podzieloną, jak w przypadku parzystego \(k\), przez liczbę wszystkich możliwości:
dla \(k\) nieparzystych.
Pozostaje jeszcze rozważyć sytuację
w której liczba serii jest nieparzysta, jak w punkcie 2., ale mniej liczne elementy rozłożone są wyłącznie w serie jednoelementowe, na przykład 001010010100, czyli liczba serii wynosi \(2n+1\), gdzie \(n\) jest liczbą mniej licznych elementów (w tym przykładzie jedynek). Wtedy znika jeden ze składników sumy z licznika powyższego równania, gdyż zachodzić może wyłącznie przypadek 2.1 lub 2.2.
Ostatecznie dostajemy następujący wzór na prawdopodobieństwo wystąpienia \(k\) serii w próbie, w której drogą niezależnych losowań wylosowano \(n_1\) zer i \(n_2\) jedynek:
gdzie \(n_\textrm{min}=\min(n_1, n_2)\) i
\(n_\textrm{max}=\max(n_1, n_2)\).
Wzór ten określa rozkład statystyki, będącej liczbą serii w próbie złożonej
z dowolnych dwóch rodzajów elementów (oznaczanych powyżej jako 0 i 1). Dzięki niemu możemy wreszcie skonstruować kompletny test hipotezy
mówiącej, że dany ciąg jest wynikiem niezależnych losowań. Przypomnijmy dane
z przykładu o nieuczciwym ankieterze:
1101101000101001011101101111010110010101001010100011101
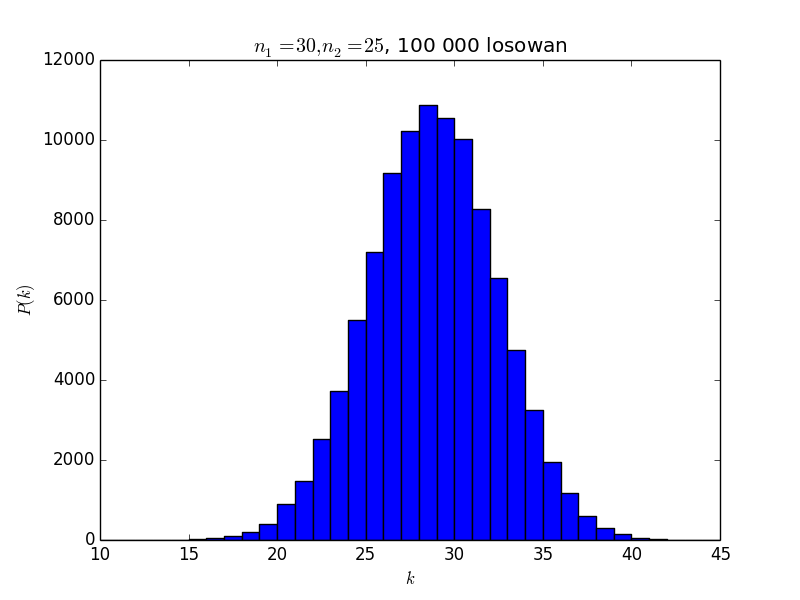
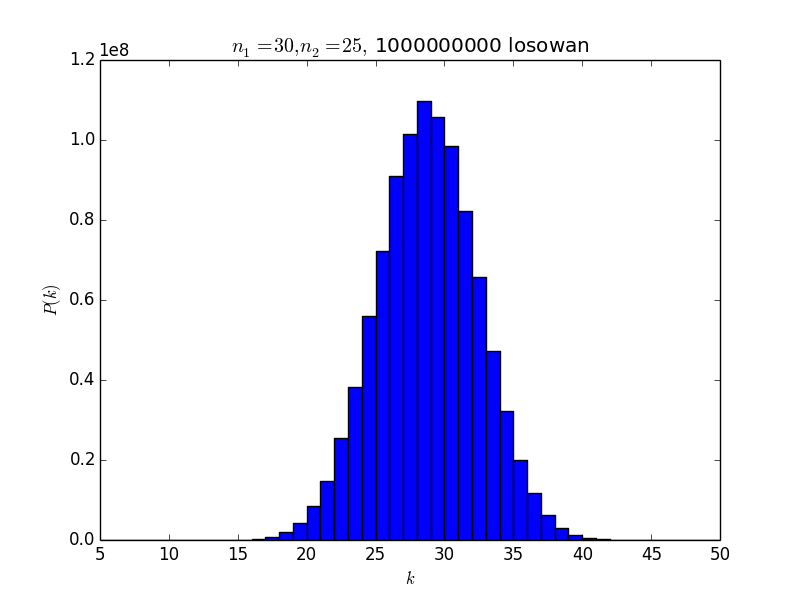
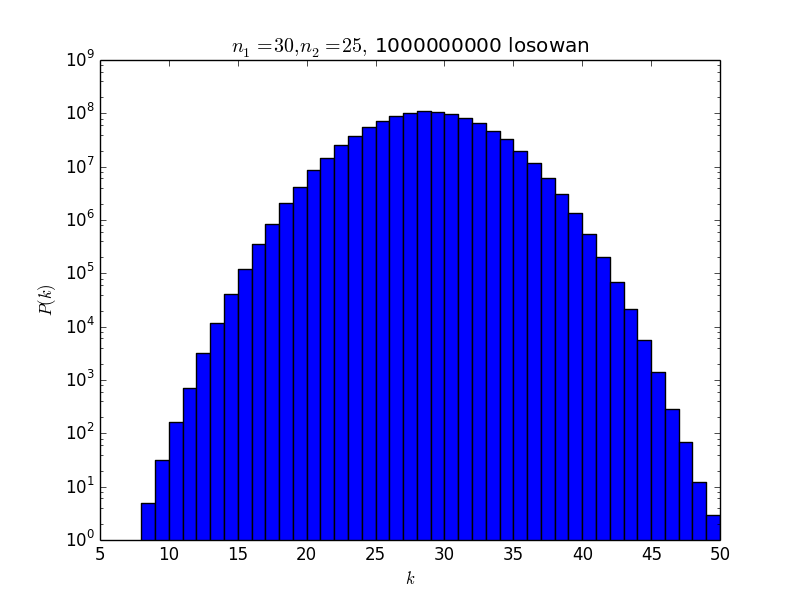
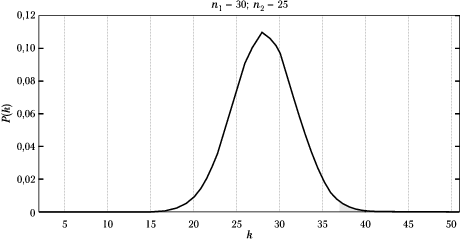
W ciągu tym występuje 25 zer i 30 jedynek, układających się w 37 serii. Na podstawie wzoru (5) możemy obliczyć rozkład prawdopodobieństwa wylosowania ciągu 25 zer i 30 jedynek, w którym będzie \(k\) serii. Możliwe wartości \(k\) będą w tym przypadku zawierać się między 2 (jedna seria zer i jedna jedynek) a 51 (ponieważ mniej jest zer, największa liczba serii odpowiada przypadkowi, w którym wszystkie zera układają się w serie jednoelementowe). Rozkład prawdopodobieństwa dla tego przypadku przedstawia poniższy rysunek.
Zastosowania testów opartych na tej statystyce nie ograniczają się do analizy ciągów zer i jedynek (lub innych dwóch elementów). Poniżej przedstawiamy jeszcze dwa testy korzystające ze statystyki (5).
Testowanie, czy próba jest wynikiem niezależnych losowań
Podobny problem — pytanie, czy elementy próby są wynikiem niezależnych losowań — występuje np. przy testowaniu generatorów liczb losowych (będących kluczowym elementem metod opisywanych w pierwszej części książki). Jednak w tej sytuacji mamy do czynienia z ciągiem dowolnych liczb, a nie dwóch symboli.
Pomysł jest prosty: ciąg wyników wyrażających się dowolnymi liczbami możemy zamienić na ciąg zer i jedynek, wybierając próg \(M\) i przypisując wynikom większym od \(M\) jedynkę, a mniejszym — zero. Jeśli chcemy mieć tyle samo zer i jedynek, jako \(M\) możemy wziąć medianę próby. Do takiej serii możemy już z powodzeniem stosować opisany w poprzednim rozdziale test oparty na statystyce (5) — oczywiście zachowując kolejność elementów w próbie.
Test zgodności rozkładów w dwóch populacjach
Mamy dwie próby. Hipoteza zerowa mówi, że zostały wylosowane z tego samego rozkładu. Ciąg zer i jedynek tworzymy w następujący sposób:
Elementy obu prób ustawiamy w jeden ciąg w kolejności od najmniejszej do największej[1]. Elementom pierwszej próby przypisujemy jedynki, a drugiej — zera.
Jeśli obie próby losowano z tej samej populacji, to liczba serii w tak określonym ciągu podlega statystyce (5), czyli ponownie możemy stosować test Walda-Wolfowitza.
<references>
- ↑ Jeśli wartości losowane są z rozkładów ciągłych, to wystąpienie jednakowych wartości jest teoretycznie niemożliwe. W praktyce wartości zapisujemy ze skończoną dokładnością; zwykle przyjmuje się, że jednakowe wartości można pominąć.