Reprezentacje przybliżone
Jako sprawdzian zrozumienia tego rozdziału (a przy okazji powtórkę z podstawowych terminów naukowych w języku angielskim) polecamy lekturę dostępnych w Internecie artykułów pt. "Multivariate matching pursuit in optimal Gabor dictionaries: theory and software with interface for EEG/MEG via Svarog", "Spindles in Svarog: framework and software for parametrization of EEG transients" i "Two-Stage Atomic Decomposition of Multichannel EEG and the Previously Undetectable Sleep Spindles".
AS/ Przybliżenia adaptacyjne (adaptive approximations)
Zrozumieć w kulturze europejskiej znaczy często powiedzieć własnymi słowami. Podobnie analiza funkcji polegać może na jej przedstawieniu—lub przybliżeniu—za pomocą funkcji o znanych właściwościach. Kontynuując tę analogię, zbiór znanych funkcji, z pomocą których będziemy chcieli wytłumaczyć funkcję nieznaną, nazwiemy słownikiem. Szczególnym przypadkiem słownika jest baza ortogonalna—najmniejszy kompletny słownik.
Z pomocą niewielu prostych i podstawowych słów można wytłumaczyć niemal dowolnie skomplikowane idee. Jednak opis z użyciem ubogiego słownika nie będzie zwięzły ani elegancki. Dla trafnego wyrażenia subtelnych i nieuchwytnych idei—bądź słabych i przejściowych składowych sygnału—potrzebujemy obszerniejszego słownika, wzbogaconego o wyrażenia fachowe lub licencję poetycką. W analizie sygnałów słownik możemy rozszerzać niemal dowolnie—wystarczy sparametryzować ogólną postać funkcji składowych.
Dokładny opis sygnału (tj. badanej funkcji) w słowniku większym niż baza wprowadza redundancję. Zwięzłość osiągnąć możemy godząc się na przybliżenie sygnału, ale za to z pomocą możliwie niewielkiej ilości funkcji. Jeśli ilość wybranych do reprezentacji sygnału funkcji słownika nazwiemy rozmiarem reprezentacji, to dążyć będziemy zwykle do sytuacji, w której:
rozmiar~reprezentacji wymiar~bazy \(\ll\) rozmiar~słownika
Reprezentację optymalną możemy określić jako taki podzbiór elementów słownika, którego liniowa kombinacja tłumaczy największy procent energii sygnału wśród wszystkich podzbiorów o tej samej liczebności. Wybór takiej reprezentacji jest obliczeniowo NP-trudny[1], toteż w praktyce zadowalamy się iteracyjnym rozwiązaniem sub-optymalnym—zaproponowanym w 1993 przez S. Mallata i Z. Zhanga algorytmem Matching Pursuit (MP).
W analizie sygnałów używamy zwykle słowników złożonych z funkcji Gabora (Gauss modulowany sinusem) ze względu na ich optymalną lokalizację w przestrzeni czas-częstość. Reprezentacja złożona z funkcji Gabora pozwala również na konstrukcję eleganckiej estymaty gęstości energii sygnału w przestrzeni czas-częstość, usuwającej a priori problem wyrazów mieszanych obecny w tego typu dystrybucjach.
Algorytm matching pursuit i słowniki czas-częstość
Niech dany będzie (słownik) zbiór funkcji (słownik) \(D = \{g_1, g_2, \ldots, g_n\}\) takich, że \(||g_i||=1\). Algorytm Matching Pursuit (MP) jest procedurą iteracyjną. W pierwszym kroku wybierana jest funkcja \(g_{\gamma_0}\) dająca największy iloczyn skalarny z sygnałem \(s\), po czym w każdym następnym kroku funkcja \(g_{\gamma_n}\) jest analogicznie dopasowywana do residuum sygnału \(R^n s\), pozostałego po odjęciu wyniku poprzedniej iteracji:
\( \left \{ \begin{array}{l} R^0s=s; \\ R^ns=\langle R^ns,g_{\gamma_n} \rangle g_{\gamma_n}+R^{n+1}s\\ g_{\gamma_n}=\arg \max_{g_{\gamma_i} \in D } |\langle R^ns, g_{\gamma_i}\rangle | \end{array} \right . \)
Ortogonalność \(R^{n+1} s\) i \(g_{\gamma_n}\) w każdym kroku procedury implikuje zachowanie energii:
\( ||s||^2 =\sum_{n=0}^{m-1} {|\langle R^n s, \;g_{\gamma_n}\rangle |^2} + ||R^m s||^2 \)
Jeśli słownik \(D\) jest kompletny, procedura zbiega do \(f\):
Dyskretny słownik funkcji Gabora
Funkcję (atom) słownika czasowo-częstościowego można wyrazić jako translację (\(u\)), rozciągnięcie (\(s\)) i modulację (\(\omega\)) funkcji okna \(g(t) \in L^2(R)\)
Optymalną lokalizację w przestrzeni czas-częstość otrzymujemy dla Gaussowskiej obwiedni \(g(t)\), co w przypadku analizy sygnałów o wartościach rzeczywistych daje słownik rzeczywistych atomów Gabora:
\( K(\gamma, \phi)\) zapewnia normalizację \(||g_{\gamma,\phi}||=1\). Pomimo, że analizujemy sygnały dyskretne, parametry dopasowywanych funkcji mogą przyjmować wartości z przedziałów ciągłych. W praktyce korzystamy z relatywnie małych podzbiorów przestrzeni parametrów \(\gamma~=~\{u,~s,~\omega\}\).[2]
Gęstość energii w przestrzeni czas-częstość
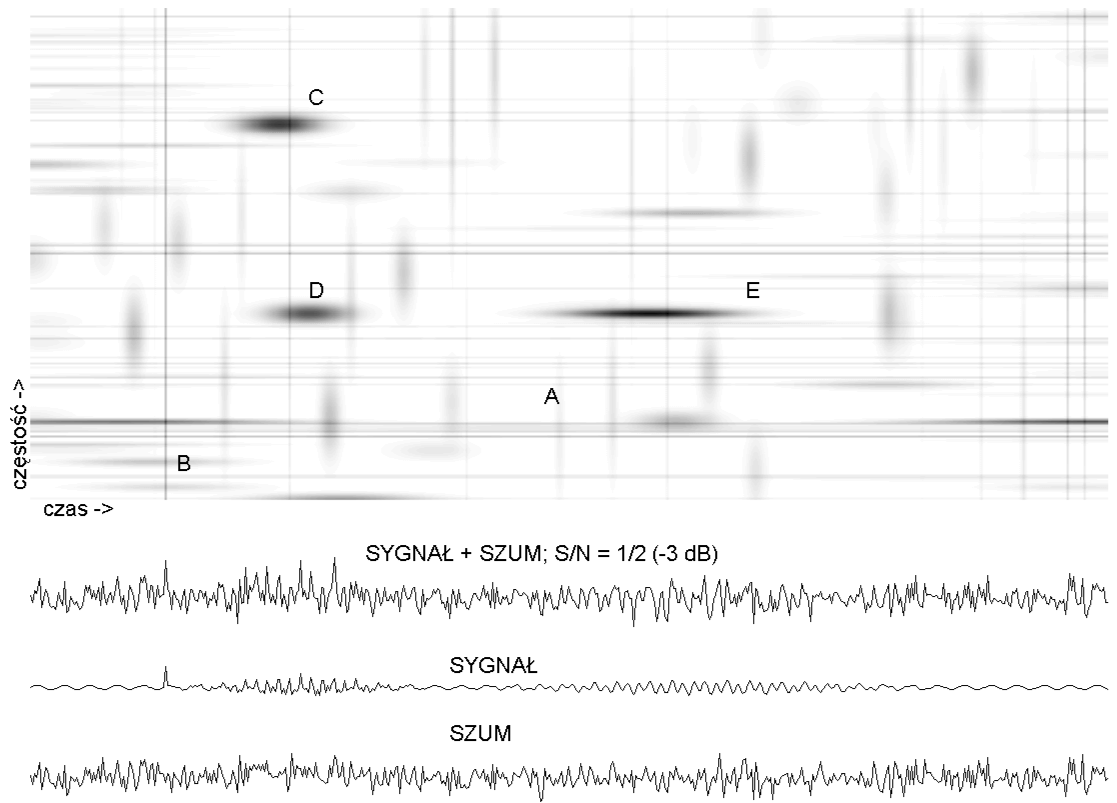 Dekompozycja sygnału z rys. %i 1 z liniowym dodatkiem szumu o dwukrotnie większej energii \((S/N = -3 dB)\). | |
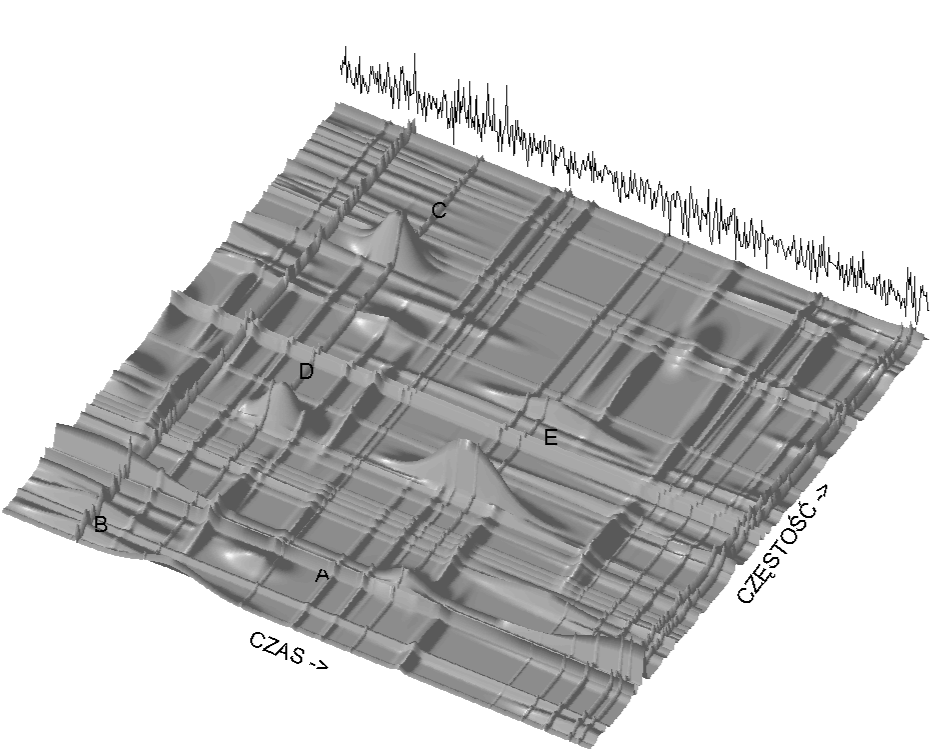 Dekompozycja sygnału z rys. %i 1 z liniowym dodatkiem szumu o dwukrotnie większej energii — widok 3D gęstości energii\((S/N = -3 dB)\). |
Z definicji transformaty Wignera
i reprezentacji sygnału w postaci sumy dopasowanych przez algorytm funkcji Gabora
(równanie %i 1) możemy skonstruować estymatę gęstości
energii sygnału w przestrzeni czas-częstość.
Transformata Wignera równania (%i 1) daje
Podwójna suma zawiera wyrazy mieszane, znacząco fałszujące obraz rozkładu energii sygnału w klasycznej transformacie Wignera i pochodnych; minimalizacja ich wkładu w tych rozkładach jest przedmiotem zastosowań zaawansowanych technik matematycznych. Dzięki rozkładowi sygnału postaci równania (%i 1), możliwe jest ich usunięcie explicite — po prostu pomijamy podwójną sumę, definiując wielkość \(E s (t,\omega)\):
Dystrybucja Wignera pojedynczego atomu \(g_\gamma\) spełnia \( \int _{-\infty}^{+\infty} \int _{-\infty}^{+\infty} \mathcal{W}_{g_{\gamma} (t, \omega)} d t d \omega = ||g_{\gamma}||^2 = 1 \) co w połączeniu z zachowaniem energii rozwinięcia MP (1) daje
Uzasadnia to interpretację wielkości \(E s(t,\omega)\) jako gęstości energii sygnału \(s(t)\) w przestrzeni czas-częstość.
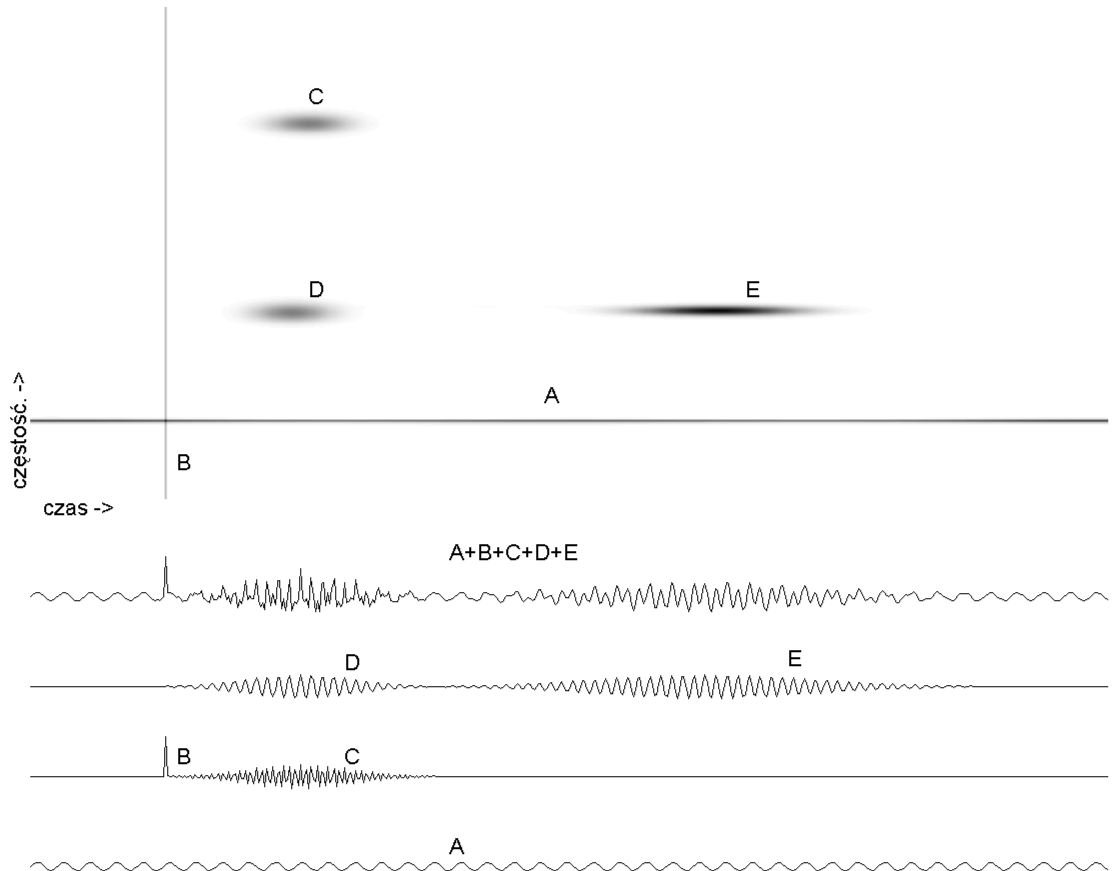
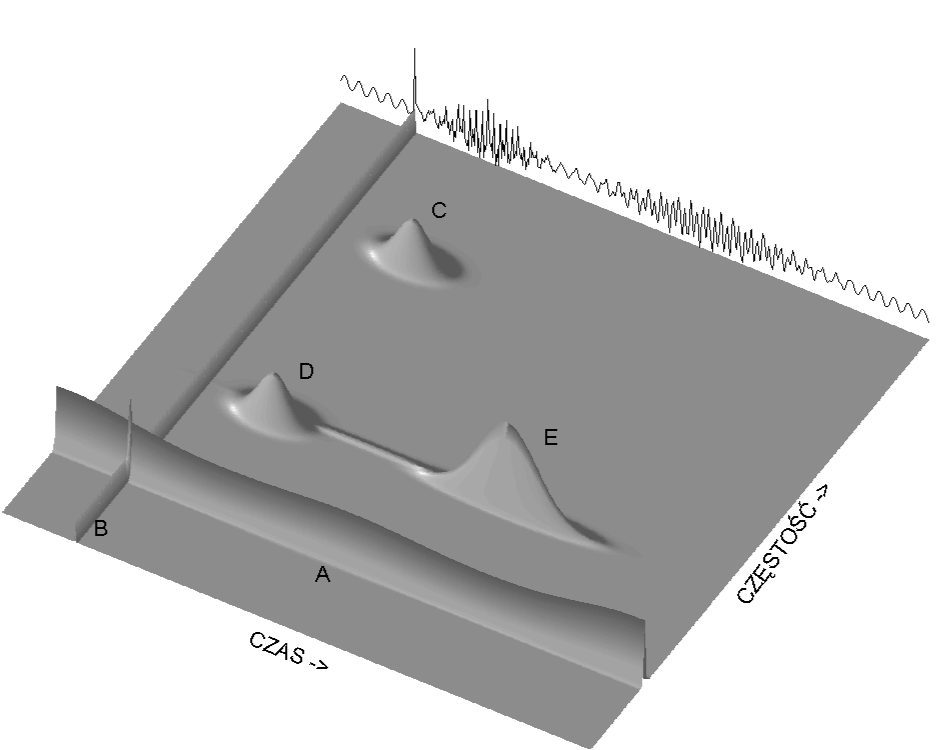
Wynik działania algorytmu ze słownikiem funkcji Gabora ilustrują rysunki %i 1 i %i 3; sygnał zasymulowano jako sumę sinusa, delty Diraca (jednopunktowej nieciągłości) i trzech funkcji Gabora o parami jednakowych położeniach w czasie i częstościach.
Wielozmienny algorytm MP (Multivariate matching pursuit, MMP)
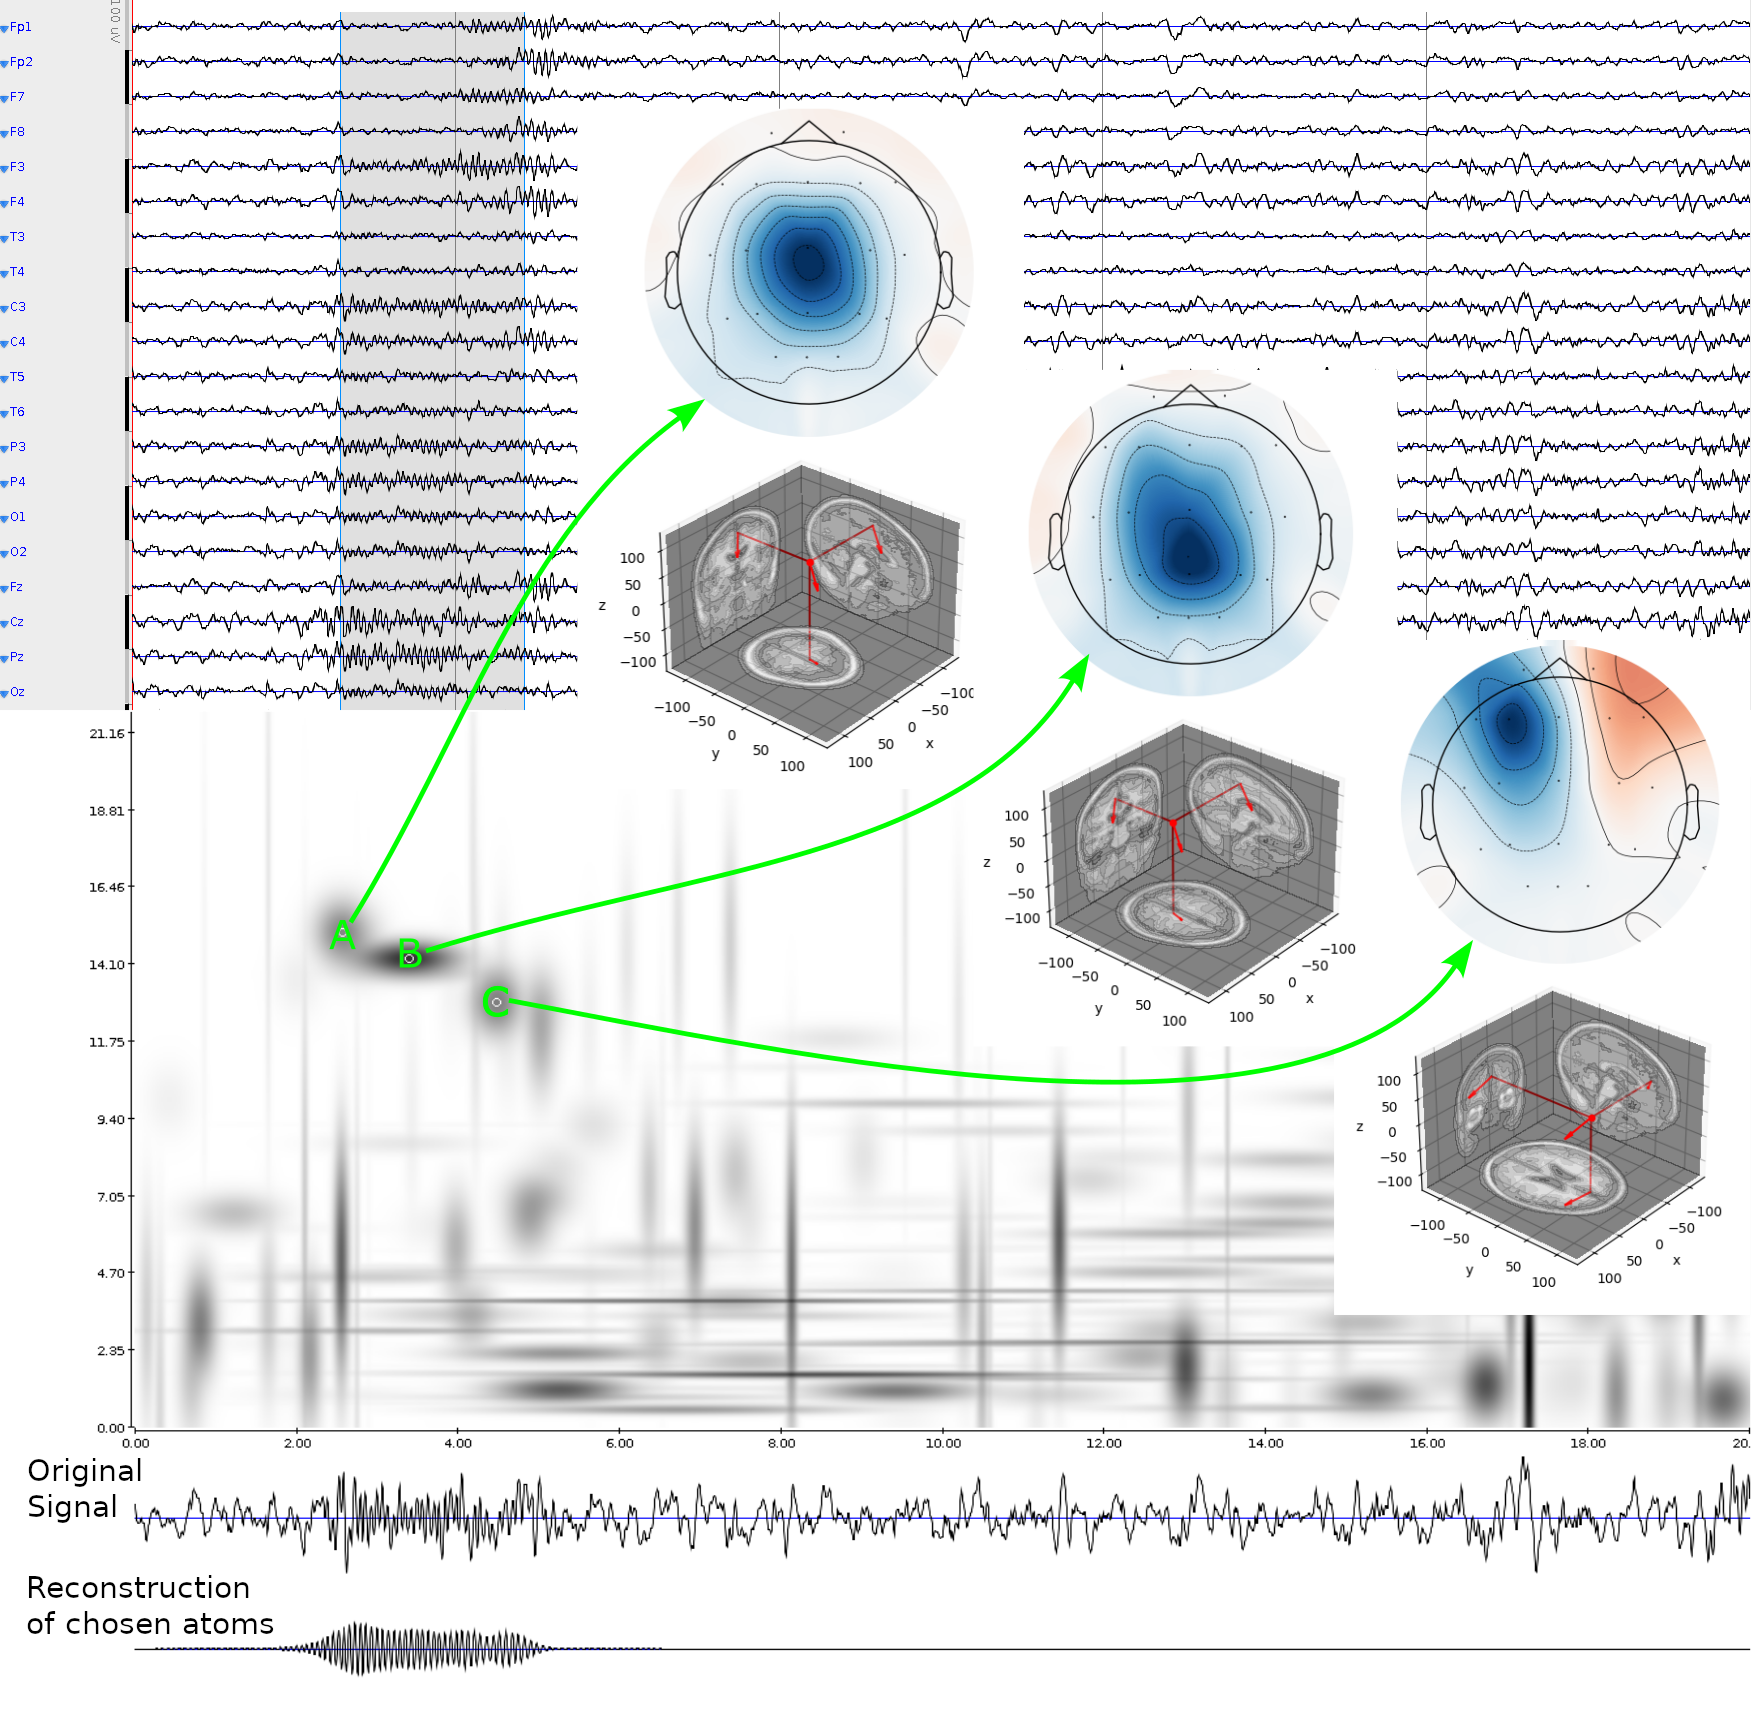
W sygnale wielozmiennym (ang. multivariate) pojedynczą próbkę zastępuje wektor wartości opisujących stan układu w danej chwili czasu, jak jak na przykład szereg parametrów opisujących stan gospodarki w danych momentach, czy też potencjał EEG mierzony z wielu elektrod jednocześnie. Jeśli chcemy w takich sygnałach szukać cech wspólnych, na przykład tych samych struktur czas-częstość występujących w sąsiednich kanałach zapisu EEG, musimy ustalić więzy określające które z parametrów funkcji dopasowywanych w każdej iteracji muszą być jednakowe (np. położenie w czasie i szerokość), a które mogą się się różnić w sąsiednich kanałąch (w sposób oczywisty różne będą amplitudy, ale może się też zmieniać np. faza).
empi — implementacja MMP
W artykule empi: GPU-Accelerated Matching Pursuit with Continuous Dictionaries opisano implementację błyskotliwej idei symulacji słownika ciągłego, dzięki której znika problem wyboru rozmiaru słownika dyskretnego. Oprogramowanie z kodem źródłowym i przykładowymi skryptami do odczytu wyników dostępne jest tutaj: https://github.com/develancer/empi
Literatura
- S. Mallat and Z. Zhang (1993) Matching pursuit with time-frequency dictionaries. IEEE Transactions on Signal Processing, 41:3397-3415.
- Piotr J. Durka (2007) Matching pursuit. Scholarpedia, 2(11):2288
- Piotr Różański (2024) empi: GPU-Accelerated Matching Pursuit with Continuous Dictionaries. ACM Transactions on Mathematical Software Vol. 50, No. 3.
- From wavelets to adaptive approximations: time-frequency parametrization of EEG
- Multivariate matching pursuit in optimal Gabor dictionaries: theory and software with interface for EEG/MEG via Svarog
- Spindles in Svarog: framework and software for parametrization of EEG transients.
- Two-Stage Atomic Decomposition of Multichannel EEG and the Previously Undetectable Sleep Spindles
Książki:
- ↑ NP-hard—klasa problemów, których złożoność obliczenowa rośnie z rozmiarem problemu szybciej niż dowolny wielomian, o czym obszerniej można przeczytać w książce Davida Harela „Rzecz o istocie informatyki. Algorytmika”. Klasycznym przykładem jest problem komiwojażera, polegający na znalezieniu najkrótszej drogi łączącej określoną liczbę miast.
- ↑ faza \(\Phi\) jest optymalizowana osobno dla każdej funkcji w jednym kroku, por. "Multivariate matching pursuit in optimal Gabor dictionaries: theory and software with interface for EEG/MEG via Svarog"